 SoulNexus
在画布中尝试 ↗
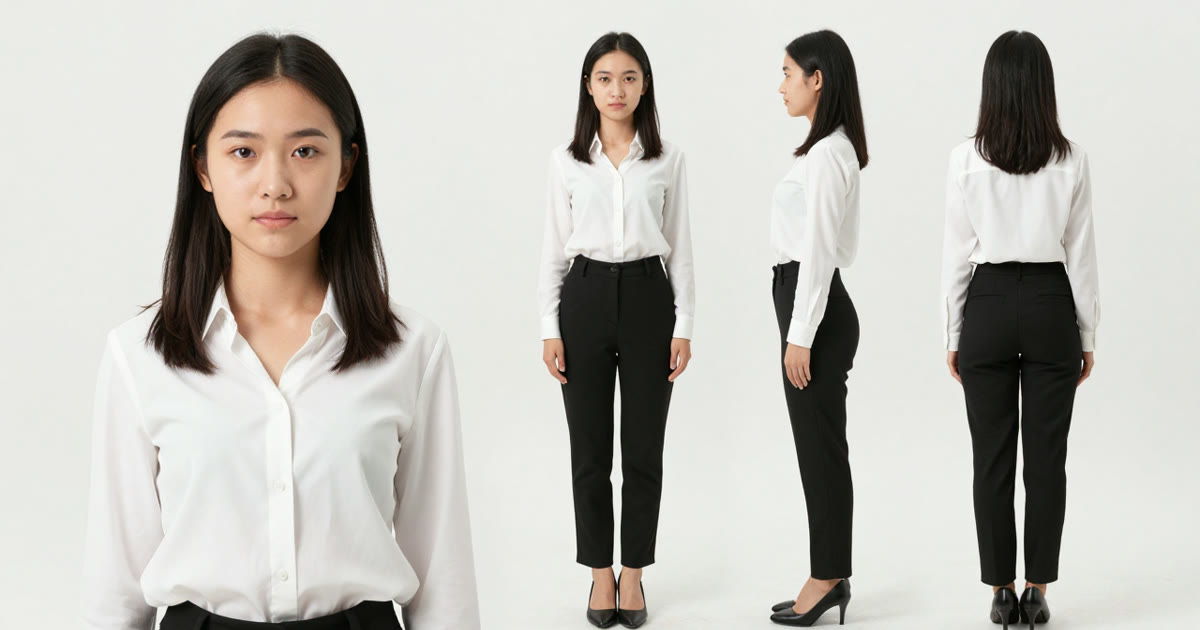
结论先说:每个角色做一张设定稿:头部正面特写,加全身正面、侧面、背面三个视图,从左到右并排,纯白背景,16:9。先检查有没有错误,再把同一张设定稿挂到这个角色出场的每一个镜头上。镜头转到侧面或背面时,模型可以照着设定稿画,而不是现编一个。
设定稿上放什么
头部正面特写。脸部细节靠它;全身视图里的脸太小,撑不住五官细节。
全身正面、侧面、背面。这是运动镜头最常用到的三个角度。
纯白背景,不要文字。设定稿上的其他东西都可能漏进镜头里。
一套服装、自然站姿、平静表情。表情写在镜头提示词里,不要放进参考图。
16:9 横版。四个视图并排放得下,脸也不会被压得太小。
动画行业用了几十年的“模型表”(model sheet)就是这个思路:让每个原画师画出同一个角色。现在这个“原画师”换成了视频模型。
提示词模板
【风格】,角色三视图设定稿:【姓名】,【年龄与身形】,【脸型五官】,【发型】,【服装与鞋】。
同一角色的头部正面特写与全身正面、侧面、背面三视图从左到右并排,各视图的脸型、发型、身材与服装完全一致,站姿自然,表情平静,纯白背景,无文字。
画面比例 16:9。
示例实际用的提示词
示例用 Z-Image 模型生成,下面是提交的原文。
电影感写实风格,柔和自然光,高清细节,角色三视图设定稿:林晚,二十六岁女性,鹅蛋脸,齐肩黑色直发,眉眼清淡,身形纤瘦,白色衬衫配黑色西装裤,黑色细跟鞋,同一角色的头部正面特写与全身正面、侧面、背面三视图从左到右并排,各视图的脸型、发型、身材与服装完全一致,站姿自然,表情平静,纯白背景,无文字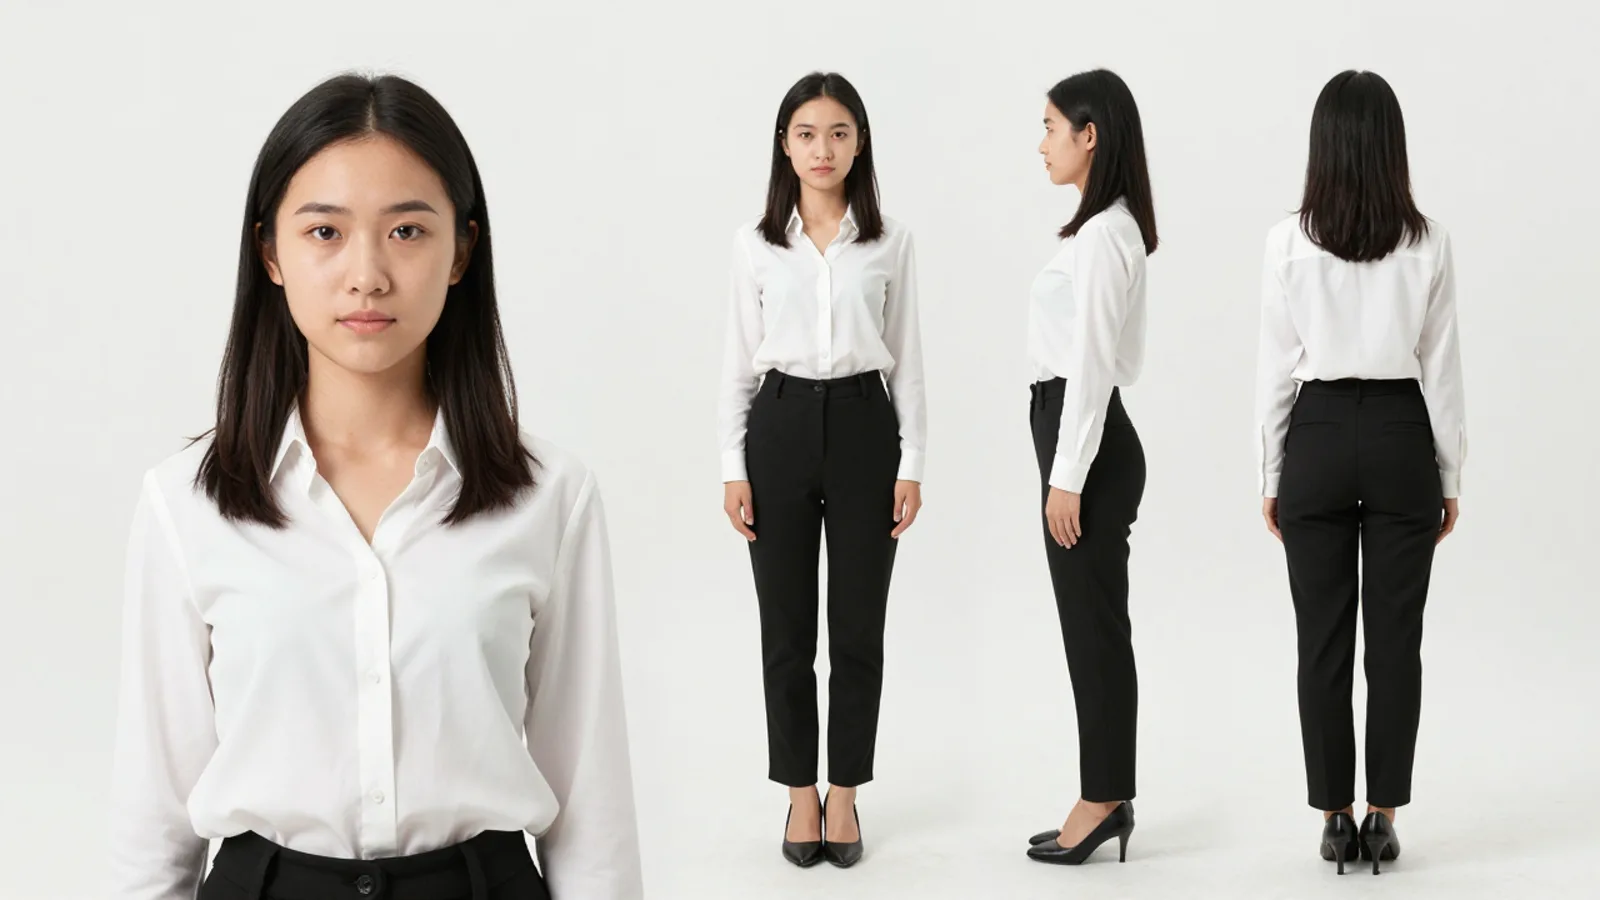
用之前先检查
每个镜头都会照抄设定稿,错误也会一起照抄。我们这张乍一看没问题,但提示词要求“齐肩”直发,生成出来明显过肩。如果这对剧情重要,现在就重做,不要等拍完十个镜头才发现。
特写和正面全身的脸型、五官一致。
四个视图里的发长、分缝、发色都与描述一致。
服装细节(领口、纽扣、鞋)从正面到背面完全一致。
脚和鞋完整入画。
没有多余的文字、水印或第二个人。
每个镜头都用同一张设定稿
角色出场的每个镜头都把设定稿作为参考图挂上,并在提示词里引用它(“@image1 中的女人”)。
一套服装或一种状态一张设定稿。换衣服或受伤了就重做一张,不要在每个镜头的提示词里描述变化。
每个角色单独一张。两个人放在一张图上容易串脸。
场景和道具单独做参考图。Seedance 2.0 每条最多 9 张参考图,Seedance 2.5 最多 30 张,放得下一张场景图和一件关键道具。
在 SoulNexus 短剧工作台中,新项目的资产步骤会为剧本里的每个角色准备好三视图设定稿提示词;设定稿画好后,会在不超过所选模型参考上限的前提下,自动挂到该角色出场的镜头上。同时,镜头提示词使用以动作为主的表演写法。
常见问题
为什么不直接用一张正面照?
正面照只有一个角度。人物一转身或走远,模型就得猜侧面和背面,而每个镜头猜的结果都不一样。
动漫或 3D 风格也适用吗?
适用。把风格写在设定稿提示词开头,每个镜头的提示词用完全相同的风格词。
设定稿上要画表情吗?
不要。设定稿保持中性,表情和动作写在每个镜头里。参考图在笑,角色往往会在每个镜头里都笑。
示例说明
这张设定稿于 2026 年 10 月 26 日用 Z-Image 模型以 16:9 生成,只生成了一次,未做修图。角色为虚构人物。
资料来源
试试这个提示词
电影感写实风格,柔和自然光,高清细节,角色三视图设定稿:林晚,二十六岁女性,鹅蛋脸,齐肩黑色直发,眉眼清淡,身形纤瘦,白色衬衫配黑色西装裤,黑色细跟鞋,同一角色的头部正面特写与全身正面、侧面、背面三视图从左到右并排,各视图的脸型、发型、身材与服装完全一致,站姿自然,表情平静,纯白背景,无文字
SOULNEXUS CANVAS
下一个故事,从这里开始。
把这个想法带入你的创作空间,何时开始生成由你决定。
在画布中尝试 ↗